Claude Fable 5.1: Khi AI agent làm việc dài hơi mà vẫn phải an toàn
Anthropic ra mắt Claude Fable 5.1 và Claude Mythos 5.1, nhấn mạnh năng lực agent dài hơi cùng các lớp an toàn và kiểm soát mới.
Anthropic cảnh báo: AI agent đang định hình các mối đe dọa mạng
Anthropic’s September 2026 threat-intelligence report details how multi-agent workflows are changing cyber operations, influence campaigns, surveillance, scams, and illicit model distillation.
Nếu AI Agent có quyền gửi email, gọi API hoặc xóa file, bạn có biết nó vừa làm g
Nếu AI Agent có quyền gửi email, gọi API hoặc xóa file, bạn có biết nó vừa làm gì không? AI Agent có thể hành động thay bạn khi được cấp công cụ. Trước khi bật một tool mới, hãy trả lời ba câu hỏi: – Agent được phép làm gì? Giới hạn rõ tool, dữ liệu và phạm vi hành động. – Khi nào phải STOP? Đặt ngưỡng rủi ro và yêu cầu xác nhận trước hành động nhạy cảm. – Có audit/replay không? Lưu Agent nào đã gọi tool, lúc nào, với tham số và kết quả gì. Agent mạnh không phải Agent có mọi quyền. Đó là Agent có quyền vừa đủ, có phanh và để lại dấu vết kiểm tra được. Hãy viết một dòng quy tắc trước khi bật tool: “Agent được làm gì, không được làm gì, phải dừng ở đâu?” Bạn ưu tiên STOP hay AUDIT? Bình luận đúng một từ và chia sẻ bài này cho người đang xây workflow AI Agent. #AIAgent #AgenticAI #AISafety #AIGovernance #SuijinGreenverses
Nếu AI Agent đang chạy 5 bước, vì sao người dùng chỉ thấy một dòng “Đang xử lý”?
Nếu AI Agent đang chạy 5 bước, vì sao người dùng chỉ thấy một dòng “Đang xử lý”? Agent có thể gọi tool, lập kế hoạch và cập nhật trạng thái. Nhưng nếu giao diện không nhận được những tín hiệu đó, trải nghiệm vẫn chỉ là một ô chat im lặng. AG-UI là gì? AG-UI có thể hiểu là một giao thức mở, nhẹ và dựa trên sự kiện, giúp agent backend trao đổi với ứng dụng hướng người dùng. Frontend nhận được tín hiệu để hiển thị đúng tiến trình. AG-UI không phải bộ UI component, cũng không có nghĩa là AI được tự do “vẽ mọi thứ”. Trong một luồng làm việc, UI có thể nhận các tín hiệu như: 🔧 Tool lifecycle: tool bắt đầu, đang stream, hoàn tất hoặc thất bại. 📍 Progress và state: agent đang ở bước nào, đang chờ dữ liệu gì. 🧩 Structured input: người dùng cần chọn phạm vi, điền form hoặc xác nhận hành động. 📊 Partial result: kết quả được gửi từng phần thay vì phải chờ câu trả lời cuối. Ví dụ, một agent tra cứu tài liệu có thể hiển thị: Đang tìm kiếm → Chọn phạm vi → Bảng kết quả → Giải thích lỗi nếu tool thất bại Người dùng không phải đoán chuyện gì đang xảy ra. Developer cũng dễ thiết kế validation, fallback và trạng thái lỗi hơn. Mức tự do nào là phù hợp? Static cho phép frontend kiểm soát cao, agent chọn các component có sẵn. Declarative cho phép agent trả về UI spec có cấu trúc. Cách này linh hoạt hơn nhưng vẫn có ranh giới. Open-ended cho agent nhiều tự do hơn, đồng thời đòi hỏi kiểm soát chặt về security, performance và consistency. Vì vậy, đừng gộp cả ba thành câu “AI tự thiết kế giao diện”. Bài toán thực tế là cân bằng freedom và control. Khi xây một agent, hãy thiết kế UI contract song song với tool contract: • Event nào được phát? • State nào cần hiển thị? • Input nào phải validate? • Nếu tool fail, người dùng sẽ thấy gì và làm bước nào tiếp theo? Agent càng hành động nhiều, giao diện càng cần minh bạch. Chat là cửa sổ; event và state là đường ống giúp người dùng quan sát con tàu đang chạy. Bạn muốn Agent hiển thị tiến trình dưới dạng timeline, card hay bảng điều khiển? Chia sẻ use case bạn đang xây ở phần bình luận và theo dõi Suijin Greenverses để cùng giải mã những lớp công nghệ phía sau AI Agent. 🌌 #SuijinGreenverse #AIAgent #GenerativeUI #AGUI #DeveloperTools
Agent xử lý xong một issue trong benchmark. Nhưng nếu không thể replay lần chạy
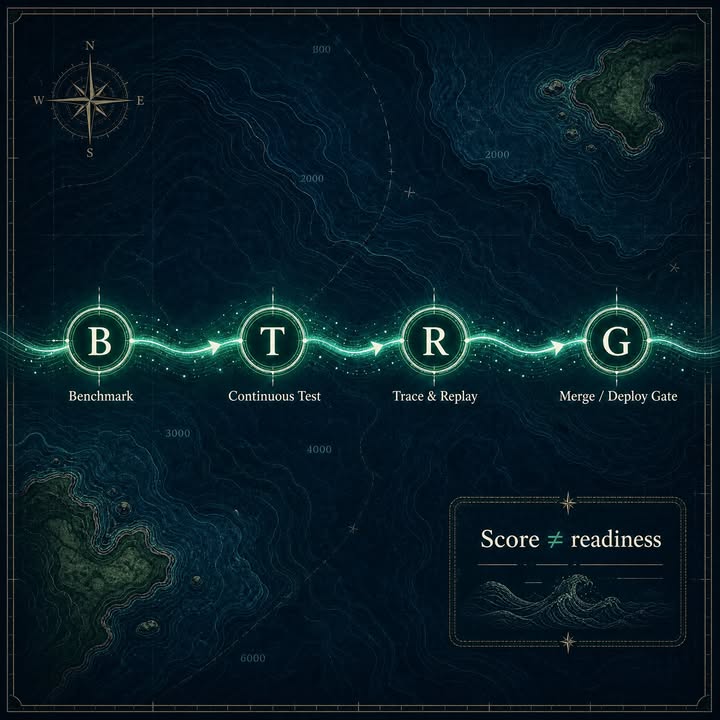
Agent xử lý xong một issue trong benchmark. Nhưng nếu không thể replay lần chạy đó, bạn đang merge một patch hay chỉ đang cược vào may rủi? Một kết quả benchmark tốt cho thấy agent xử lý được một nhóm task trong một setup cụ thể. Nó chưa trả lời câu hỏi quan trọng hơn: khi chạm vào codebase thật, team có biết agent đã làm gì, vì sao nó sai và chặn nó ở đâu không? Có thể nhìn một AI coding agent qua 4 lớp B/T/R/G: – B, Benchmark: agent có giải được task mẫu với tiêu chí rõ ràng không? – T, Continuous Test: khi codebase hoặc dependency thay đổi, kết quả còn ổn định không? – R, Trace & Replay: có lưu tool call, trạng thái và log để tái hiện lần chạy không? – G, Merge/Deploy Gate: patch có qua test, review, policy và workspace cô lập trước khi merge hoặc deploy không? OpenHands SDK dùng event làm nền cho trạng thái hội thoại và hỗ trợ replay. AgentLab là framework để phát triển và đánh giá web agent qua benchmark, thí nghiệm quy mô lớn và các tính năng reproducibility. Hai ví dụ này gợi ra một cách làm thực tế: xây vòng đánh giá quanh agent, thay vì chỉ nhìn một con số trên leaderboard. SWE-bench Verified là một bộ đánh giá tĩnh. Khác biệt về release và setup có thể khiến kết quả khó so sánh. Vì vậy, benchmark pass chỉ nên là tín hiệu đầu vào. Quyền merge vẫn cần thuộc về quy trình kiểm thử, truy vết và review của team. Câu hỏi đáng hỏi không chỉ là “agent đạt bao nhiêu điểm?”. Mà là: “Nếu agent sai, tôi có tái hiện được, giải thích được và chặn được lần chạy đó không?” Trong quy trình của bạn, lớp nào còn thiếu: B, T, R hay G? Comment một chữ và nói ngắn lý do. Nếu thấy hữu ích, hãy lưu bài viết để dùng khi review AI coding agent và chia sẻ cho người đang cân nhắc merge patch do agent tạo. #SuijinGreenverse #AIAgent #DevTools #SoftwareEngineering Nguồn tham khảo: https://github.com/OpenHands/software-agent-sdk https://github.com/ServiceNow/AgentLab/blob/main/README.md https://openai.com/index/introducing-swe-bench-verified/ https://www.swebench.com/verified.html
Một AI Agent có thể rất thông minh nhưng vẫn chật vật khi bước vào production.
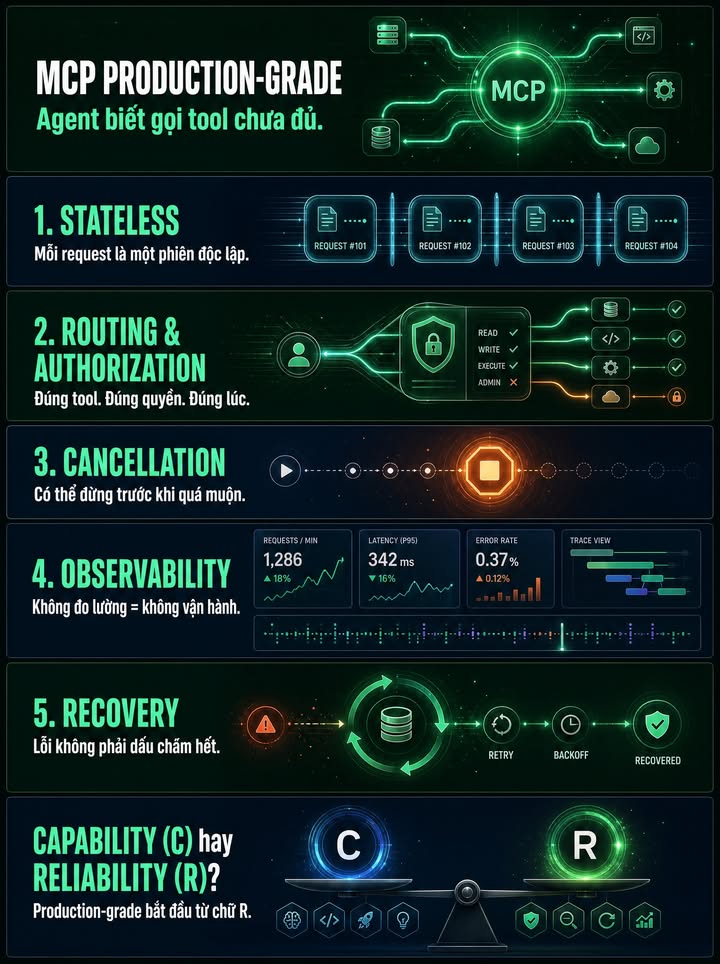
Một AI Agent có thể rất thông minh nhưng vẫn chật vật khi bước vào production. MCP 2026-07-28 đưa lớp kết nối của Agent gần hơn với cách hạ tầng web hiện đại vận hành: request tự mô tả, ít phụ thuộc vào session và dễ phân phối qua nhiều instance. Điểm đáng chú ý: Stateless protocol core: mỗi request mang theo thông tin cần thiết, giúp hệ thống dễ scale ngang hơn qua load balancer. Điều này không có nghĩa ứng dụng không được giữ state; state nghiệp vụ vẫn cần được quản lý ở tầng ứng dụng. Header-based routing: Mcp-Method và Mcp-Name cho phép gateway, rate limiter hoặc WAF route và kiểm soát request từ header, thay vì phải đọc body JSON. MRTR: Multi Round-Trip Requests xử lý những tình huống tool cần thêm thông tin hoặc xác nhận giữa chừng mà không phải giữ một kết nối hai chiều mở liên tục. Cache hints: các phản hồi list có thông tin như ttlMs và cacheScope, giúp client cân nhắc cách cache catalog tool, prompt và resource. Nhưng MCP không tự động biến một hệ thống thành production-grade. Đội ngũ vẫn phải kiểm thử tương thích, thiết kế quyền tối thiểu, theo dõi request, xử lý hủy tác vụ và chuẩn bị recovery khi tool hoặc upstream gặp lỗi. Với tác vụ dài, hãy xem xét cơ chế Tasks; với state nghiệp vụ, hãy truyền một handle rõ ràng ở tầng ứng dụng. Khi Agent gọi CRM, kho đơn và hệ thống hoàn tiền, câu hỏi không chỉ là “model thông minh đến đâu?” mà còn là “hệ thống có route đúng, cấp đúng quyền và phục hồi được khi có sự cố không?” Nếu phải ưu tiên một tiêu chí cho Agent production, bạn chọn Capability hay Reliability? Comment “C” hoặc “R” và nói rõ lý do. Lưu bài để dùng làm checklist trước khi scale. #AIAgent #MCP #AIInfrastructure #AgentEngineering #SuijinGreenverses
Bạn gọi đó là “AI tự chủ” — nhưng ai đang giữ nút STOP?
Bạn gọi đó là “AI tự chủ” — nhưng ai đang giữ nút STOP? Một agent không chỉ tự chủ vì model thông minh hơn. Mức tự chủ còn được quyết định bởi chiến lược giám sát của con người và cách sản phẩm trao quyền cho nó. 🌊 Hãy tách 3 khái niệm thường bị trộn lẫn: • Capability — model có thể làm được gì?• Autonomy — agent có thể tự đi qua bao nhiêu bước trước khi cần người can thiệp?• Permission — agent thực sự được phép làm gì trong hệ thống? Ba lớp này không đồng nghĩa. Một model có thể lập kế hoạch rất tốt, nhưng vẫn nên chạy trong phạm vi quyền hạn hẹp. Ngược lại, một agent “ít thông minh hơn” nhưng được cấp quyền rộng, auto-approve nhiều và thiếu cơ chế hoàn tác có thể tạo ra rủi ro lớn hơn. 📌 Nghiên cứu của Anthropic trên hàng triệu tương tác cho thấy: • Session Code dài nhất tăng từ dưới 25 lên trên 45 phút trong 3 tháng.• Tỷ lệ full auto-approve khoảng 20% ở người dùng mới và trên 40% ở nhóm nhiều kinh nghiệm.• Gần 50% hoạt động agentic trên public API gắn với software engineering. Những con số này không nói rằng “AI đã tự chủ hoàn toàn”. Chúng cho thấy một điều thực tế hơn: con người đang dần thiết kế những vòng lặp dài hơn và trao cho agent nhiều quyền hơn — tùy theo mức độ tin tưởng, khả năng giám sát và độ dễ hoàn tác của công việc. ⚓ Vì vậy, khi đưa agent vào production, câu hỏi quan trọng không phải là: “Model này thông minh đến đâu?” Mà là: 1. Agent được phép truy cập dữ liệu và công cụ nào?2. Hành động nào cần người xác nhận?3. Nếu làm sai, có rollback được không?4. Ai có quyền ngắt quy trình?5. Ta đang đo autonomy bằng dữ liệu nào — và dữ liệu đó có đại diện cho mọi ngành không? 🧭 Nói thật: nghiên cứu trên tập trung vào Claude Code/public API và các tác vụ liên quan đến coding. “Autonomy” ở đây là một khái niệm vận hành, không phải benchmark năng lực chung cho mọi model hay mọi loại agent. Không nên lấy các tỷ lệ trên để suy ra rằng agent trong doanh nghiệp nào cũng sẽ đạt cùng mức tự chủ. Cách đi an toàn hơn là bắt đầu từ vùng nước nông: • Quyền hạn tối thiểu• Hành động có thể đảo ngược• Logging và evaluation rõ ràng• Human escalation ở các điểm rủi ro cao• Mở rộng autonomy chỉ sau khi có bằng chứng vận hành Agent giỏi là lợi thế. Agent được trao đúng quyền mới là hệ thống có thể sống sót ngoài biển lớn. Agent của bạn hiện đang được phép làm gì mà chưa có cơ chế rollback? Chia sẻ một quyền hạn bạn sẽ giữ lại ở chế độ “cần người duyệt” — và vì sao. #AIAgent #AgenticAI #AIGovernance #Automation #SuijinGreenverse Nguồn gốc: https://www.facebook.com/122110280187349377/posts/122132395041349377
AI đang rời khỏi ô chat. Nó bắt đầu nhận việc.
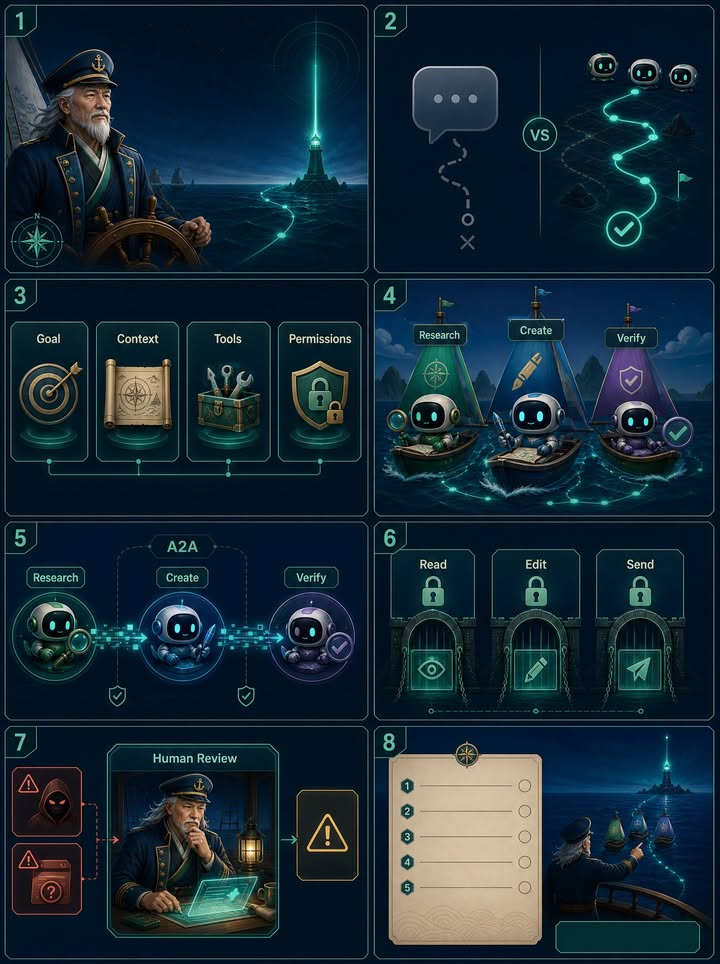
AI đang rời khỏi ô chat. Nó bắt đầu nhận việc. Ngày trước, ta giao cho chatbot một câu hỏi. Bây giờ, ta có thể giao cho một agent cả một nhiệm vụ: “Đọc 10 nguồn đáng tin, so sánh các phương án, viết bản tóm tắt và đánh dấu chỗ cần tôi duyệt.” Chatbot thường tạo một câu trả lời trong một lượt. Agent có thể xử lý nhiều bước trong giới hạn được cấp: nhận mục tiêu, tìm dữ liệu, dùng công cụ, phối hợp với agent khác rồi gửi kết quả để con người kiểm tra. Một agent muốn làm việc tử tế cần 4 mảnh ghép: 🎯 Mục tiêu: Kết quả cuối là gì? Bản nghiên cứu, báo cáo, email hay một quyết định có điều kiện? 🧭 Context và dữ liệu: Agent được đọc nguồn nào, phiên bản nào, dữ liệu nào là nội bộ? Không có context đúng, agent chỉ đang đoán có vẻ tự tin. 🛠️ Công cụ: Tìm kiếm, đọc file, gọi API, cập nhật bảng, tạo bản nháp. Công cụ giúp agent chuyển từ biết sang làm. 🔐 Quyền hạn và vòng kiểm tra: Agent được phép xem gì, sửa gì, gửi gì? Những hành động có thể gây hậu quả cần permission gate và human review, nhất là trước khi gửi ra ngoài, xóa dữ liệu hoặc chi tiền. Hãy hình dung một đội nhỏ trên hạm đội tri thức: 🔎 Research tìm và đối chiếu nguồn. ✍️ Create biến kết quả thành bản nháp. ✅ Verify kiểm tra dẫn chứng, lỗi và điều kiện an toàn. Ba agent có thể bàn giao việc cho nhau. A2A, viết tắt của Agent-to-Agent, là giao thức giúp các agent phối hợp. Trong một số cách triển khai, agent chuyên môn có thể giữ dữ liệu và quy trình trong ranh giới riêng, rồi trả về cho agent yêu cầu phần kết quả cần thiết. Cách vận hành cụ thể vẫn phụ thuộc vào thiết kế hệ thống và quyền truy cập. Một vài tín hiệu cho thấy agent đang được đưa vào công việc thực tế: • OpenAI báo cáo Codex tạo 64% tổng output token kết hợp giữa Codex và ChatGPT ở khách hàng doanh nghiệp. Nhóm doanh nghiệp dùng AI ở mức cao tạo 8,3 lần output token trên mỗi người dùng hoạt động so với nhóm điển hình. Đây là chỉ báo về độ sâu sử dụng, không phải cam kết năng suất hay ROI. • Trang giới thiệu báo cáo “2026 State of AI Agents” của Anthropic nêu 80% tổ chức được khảo sát báo ROI đo được; mẫu gồm hơn 500 lãnh đạo kỹ thuật. Đây là số liệu theo báo cáo của Anthropic, cần đọc cùng phương pháp khảo sát và bối cảnh triển khai. • Google mô tả A2A qua các tình huống agent chuyên môn nhận việc, làm việc trong môi trường riêng và trả kết quả cho agent yêu cầu. Càng được giao việc, agent càng cần hàng rào: ⚠️ Least privilege: chỉ cấp đúng quyền cần cho nhiệm vụ. ⚠️ Prompt injection: dữ liệu được đọc có thể chứa chỉ dẫn độc hại. ⚠️ Nguồn sai: agent có thể tổng hợp một điều không đúng từ những nguồn trông rất hợp lý. ⚠️ Hành động không hoàn tác: gửi email, xóa file, thay đổi dữ liệu hay giao dịch phải có bước duyệt rõ ràng. Trước khi giao việc cho AI, hãy hỏi: 1. Kết quả nào chứng minh nhiệm vụ đã xong? 2. Agent được đọc dữ liệu nào, và không được đọc dữ liệu nào? 3. Agent cần công cụ và quyền hạn gì? 4. Bước nào bắt buộc con người kiểm tra? 5. Nếu agent sai hoặc hành động nhầm, ta có thể hoàn tác ra sao? Nếu được giao một việc ngay hôm nay, bạn sẽ giao cho AI việc gì trước: nghiên cứu, viết bản nháp hay kiểm tra một quy trình? Bình luận để Suijin cùng bạn tách nhiệm vụ ra nhé! 👇 #AIAgents #Agents #OpenAI #Anthropic #GoogleA2A #SuijinGreenVerses
Bạn không còn chat với AI để hỏi một câu. Bạn đang giao cho nó một ca làm việc.
Bạn không còn chat với AI để hỏi một câu. Bạn đang giao cho nó một ca làm việc. Trước đây, ta thường dùng AI cho từng việc ngắn: – “Tóm tắt tài liệu này.” – “Viết giúp tôi một email.” – “Giải thích khái niệm này.” Một AI Agent có thể nhận mục tiêu dài hơn, chia việc thành nhiều bước, gọi công cụ, kiểm tra kết quả và dừng lại khi cần người quyết định. Khác biệt nằm ở cách giao việc: – Chatbot thường trả lời một lượt. – Agent theo đuổi một đầu việc qua nhiều bước để đi đến kết quả. Đó là sự chuyển dịch từ “một lần tương tác” sang “một ca làm việc được giao”. Một vài tín hiệu từ các báo cáo gần đây: – Theo OpenAI, trong mẫu người dùng Codex cá nhân được phân tích, 80,6% từng gửi ít nhất một yêu cầu được ước tính tương đương hơn 30 phút làm việc của con người; 70,2% hơn 1 giờ; 25,6% hơn 8 giờ. Đây là dữ liệu của mẫu người dùng Codex, không phải thống kê toàn thị trường. – Anthropic ghi nhận thời lượng làm việc của Claude Code trong nhóm session dài nhất tăng từ dưới 25 phút lên hơn 45 phút. Đây là quan sát ở phân vị 99,9%, không có nghĩa mọi session đều chạy lâu như vậy. Tự chủ hơn không có nghĩa là phó mặc. Khi giao một ca làm việc cho AI Agent, hãy giữ bốn lớp kiểm soát: 1. Human review: người chịu trách nhiệm duyệt quyết định quan trọng. 2. Checkpoint: chia việc dài thành các mốc để kiểm tra và đổi hướng. 3. Quyền tối thiểu: chỉ cấp đúng công cụ và quyền truy cập cần thiết. 4. Evidence: lưu đầu ra, nguồn, log hoặc kết quả kiểm thử để biết agent đã làm gì. Hãy xem AI Agent như một cộng sự làm việc qua nhiều bước, không phải một chiếc hộp đen được miễn kiểm tra. Nếu giao một “ca làm việc” cho AI Agent hôm nay, bạn sẽ giao việc gì? 💬 Chia sẻ một workflow bạn muốn tự động hóa. 🔖 Lưu bài để dùng checklist trước khi giao việc dài. ↗️ Chia sẻ cho người đang bắt đầu xây quy trình với AI Agent. #AIAgent #GenerativeAI #AIWorkflow #AISafety #SuijinGreenverses Nguồn: – OpenAI: https://openai.com/index/how-agents-are-transforming-work/ – Anthropic: https://www.anthropic.com/news/measuring-agent-autonomy – Anthropic: https://www.anthropic.com/news/our-framework-for-developing-safe-and-trustworthy-agents
Nếu chatbot thường trả lời từng câu hỏi, AI Agent có thể nhận một nhiệm vụ, sử d
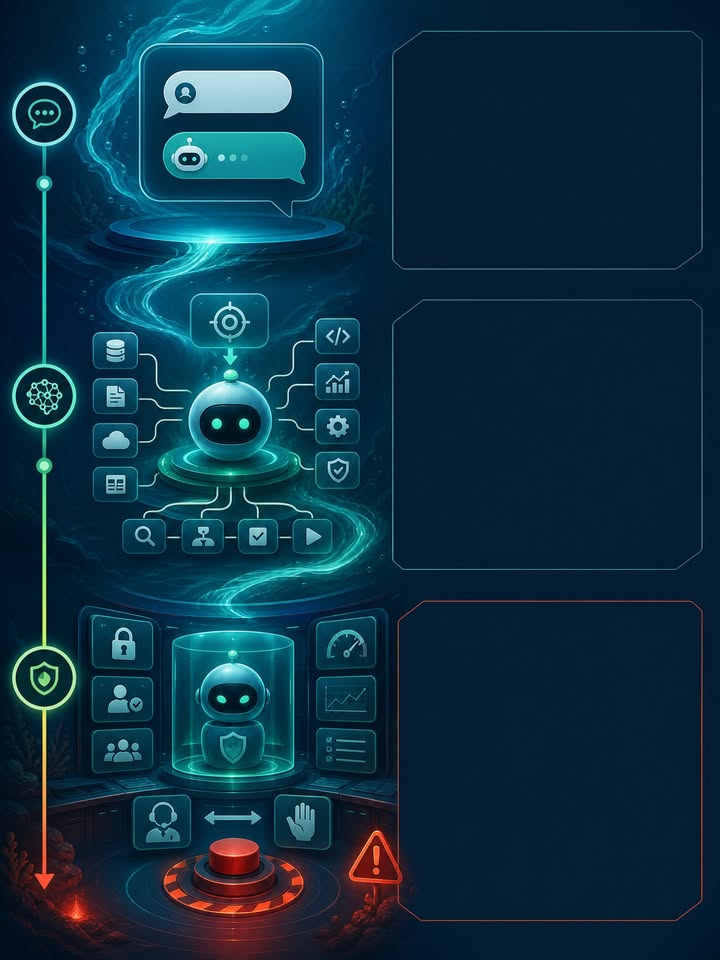
Nếu chatbot thường trả lời từng câu hỏi, AI Agent có thể nhận một nhiệm vụ, sử dụng công cụ và tự tiến hành qua nhiều bước. Nhưng bạn có dám giao quyền mà không biết nó đã làm gì trong 8 giờ qua? Bước chuyển lớn của AI Agent không chỉ là tạo câu trả lời hay hơn. Đó là sự thay đổi của đơn vị lao động: từ một lượt hỏi–đáp sang một nhiệm vụ dài hạn có mục tiêu, công cụ, thời gian thực thi và kết quả cần kiểm chứng. Dữ liệu OpenAI công bố vào tháng 6/2026, được thu thập đến tháng 5/2026, cho thấy 70,2% người dùng Codex trong mẫu khảo sát đã có ít nhất một yêu cầu được ước tính tương đương hơn một giờ làm việc của con người; 25,6% có ít nhất một yêu cầu tương đương hơn tám giờ. Đây là các ước tính theo mô hình, mang tính định hướng chứ không phải phép đo tuyệt đối. Tín hiệu đáng chú ý là người dùng đang chuyển từ hỏi AI sang giao cho AI một phần quy trình. Tại OpenAI, Codex cũng đã trở thành công cụ AI chính của mọi phòng ban; Legal, Finance và Recruiting là những nhóm phi kỹ thuật chuyển sang sử dụng chính vào khoảng tháng 4/2026. Điều này không có nghĩa agent thay thế toàn bộ công việc. Nó cho thấy giá trị nằm ở việc tách một quy trình thành các bước có thể giao, theo dõi và đánh giá. Hãy hình dung một agent nghiên cứu thị trường cho doanh nghiệp nhỏ. Nó có thể thu thập dữ liệu, so sánh đối thủ, lập bảng tóm tắt và đề xuất hướng hành động. Nhưng để biến bản demo thành một “nhân sự số” đáng tin, bốn câu hỏi phải được trả lời rõ ràng: Agent được giao workflow nào? Agent được phép đọc và thay đổi dữ liệu gì? Kết quả được đo bằng tiêu chí nào? Khi nào agent phải dừng lại và gọi người? Tự chủ không đồng nghĩa với toàn quyền. Khi đánh giá các hệ thống agentic có năng lực cao, OpenAI nhấn mạnh các biện pháp như môi trường cô lập, giới hạn mạng và công cụ, giám sát hành động rủi ro, sandbox và cơ chế ngắt. Phân tích của Google Red Teams cũng cảnh báo agent có thể làm tăng tốc độ, quy mô và năng lực vận hành của các cuộc tấn công. Một agent chạy được lâu hơn cần nhiều dây an toàn hơn, không phải ít hơn. Đánh giá cũng phải đi xa hơn bảng xếp hạng model. Nghiên cứu SciAgentArena của Microsoft Research cho thấy agent có thể đóng góp hiệu quả trong các workflow phân tích dữ liệu được đặc tả rõ, nhưng vẫn gặp khó khăn khi cần tạo insight mới, tự định hướng khám phá và hình thành lời giải cho câu hỏi nghiên cứu mở. Vì vậy, một bài test thực tế nên đo ít nhất: Kết quả có đúng và lặp lại được không? Agent mất bao lâu và tiêu tốn bao nhiêu tài nguyên? Bao nhiêu lần phải chuyển cho con người? Agent có làm gì ngoài phạm vi được cấp không? Với doanh nghiệp nhỏ, có thể bắt đầu bằng một khung ba lớp: Một: chọn một workflow cụ thể, đủ hẹp để biết thế nào là hoàn thành. Hai: cấp đúng dữ liệu và quyền tối thiểu, tránh trao quyền chỉ vì “để agent tự xử lý”. Ba: đặt evaluator, ngưỡng chuyển người và nhật ký hành động trước khi mở rộng phạm vi. Đừng hỏi: “Agent này thông minh đến đâu?” Hãy hỏi: “Agent này được giao việc gì, được phép làm gì, đo bằng tiêu chí nào và khi nào phải gọi người?” Bạn sẽ giao quy trình nào đầu tiên cho một AI Agent: chăm sóc khách hàng, nghiên cứu hay vận hành? Hãy để lại lựa chọn của bạn và lý do. #AIAgent #AgentProductionReadiness #AIEnterprise #ResponsibleAI #SuijinGreenverse